Tomcat multipart part 제한을 설정 상향 대신 요청 구조 개선으로 해결
3,000명의 데이터를 `multipart/form-data`로 전송하면서 발생한 `FileCountLimitExceededException`을 분석하고, 약 9,000개의 multipart part를 1개로 줄인 과정을 정리했습니다.
들어가며
교육 과정과 대상자를 일괄 등록하는 기능을 개발하면서, 등록 대상자가 일정 수를 넘으면 요청이 실패하는 문제가 발생했다.
처음에는 엑셀 파일의 용량이나 multipart 요청 전체 크기 제한을 의심했다. 하지만 로그를 확인해 보니 문제는 파일 크기가 아니라 multipart 요청에 포함된 part 개수였다.
org.springframework.web.multipart.MultipartException:
Failed to parse multipart servlet request

Caused by:
org.apache.tomcat.util.http.fileupload.impl.FileCountLimitExceededException
기존에는 이 문제를 피하기 위해 한 번에 등록할 수 있는 대상자를 약 50명으로 제한하고 있었다. 하지만 업무상 최대 3,000명까지 한 번에 등록해야 했기 때문에 근본적인 개선이 필요했다.
이 글에서는 다음 내용을 다룬다.
- 기존 API가
multipart/form-data를 사용했던 이유 maxPartCount제한이 존재하는 이유- 파일 크기가 작아도 multipart 요청이 실패한 이유
- 제한값을 단순히 높이지 않은 이유
- 대상자 데이터를 단일 JSON part로 변경한 과정
- 대량 처리 후 성공·실패 건수와 사유를 로그로 확인할 수 있게 한 방법
1. 기존 API는 왜 multipart/form-data를 사용했을까?
해당 API는 한 번의 요청으로 다음 데이터를 함께 받아야 했다.
- 교육 제목
- 교육 기간
- 신청 기간
- 신청 가능 인원
- 교육 대상 조건
- 개별 신청 대상자 목록
- 첨부파일
첨부파일과 일반 폼 데이터를 한 번에 보내려면 multipart/form-data를 사용하는 것이 자연스럽다.
서버는 이 요청에서 교육 제목·기간 같은 입력값과 첨부파일을 나누어 처리하고 있었다.
교육 제목·기간 같은 입력값은 EducationDetailDto라는 자바 객체에 모아 담았다. 예를 들어 화면에서 title이라는 이름으로 교육 제목을 보내면, Spring이 그 값을 객체의 title 속성에 넣어 준다. 개발자가 입력값을 하나씩 꺼내 객체에 넣는 대신, 전송한 필드 이름과 객체의 속성 이름을 맞춰 자동으로 채워 주는 것이다. 이 작업을 바인딩이라고 하며, 컨트롤러의 @ModelAttribute가 이 역할을 맡는다. 이렇게 요청 값을 모아 다음 처리 단계에 전달하는 객체를 DTO(Data Transfer Object)라고 부른다.
첨부파일은 별도로 처리했다. MultipartHttpServletRequest는 multipart 요청에 들어 있는 파일을 꺼낼 수 있게 해 주는 요청 객체다. 아래 코드에서는 이 요청 객체와 교육 정보가 담긴 DTO를 서비스에 함께 넘긴다. 서비스는 요청 객체에서 파일을 읽고, DTO에서 교육 제목·기간 등을 읽어 등록 처리를 진행한다.
간략하게 표현하면 다음과 같은 구조였다.
// POST /education으로 들어온 multipart 요청을 처리하는 컨트롤러다.
@PostMapping(
    value = "/education",
    // 파일과 일반 입력값을 함께 보내는 요청 형식을 받는다.
    consumes = MediaType.MULTIPART_FORM_DATA_VALUE
)
public Map<String, Long> createEducation(
        // Spring이 일반 입력값을 education에 채우고, @Valid로 선언된 검증 조건을 확인한다.
        @Valid @ModelAttribute EducationDetailDto education,
        // 첨부파일을 읽을 때 사용할 원본 요청 객체다.
        HttpServletRequest request
) {
    // 파일을 읽을 수 있는 요청 객체와 교육 정보를 서비스에 전달한다.
    long educationId = educationService.create(
        (MultipartHttpServletRequest) request,
        education
    );

    // 등록된 교육의 식별값을 응답으로 돌려준다.
    return Map.of("educationId", educationId);
}
초기에는 대상자 수가 많지 않았기 때문에 개별 대상자 정보도 일반 폼 파라미터로 전송했다.
targetBatchList[0].userNo
targetBatchList[0].apntmUserNo
targetBatchList[0].essentialYn

targetBatchList[1].userNo
targetBatchList[1].apntmUserNo
targetBatchList[1].essentialYn
백엔드에서는 파라미터 이름을 기반으로 대상자 수를 계산하고 각 값을 직접 읽었다.
// 요청 필드 중 대상자의 userNo 필드 개수를 세어 반복 처리할 인원 수를 구한다.
int size = (int) Collections.list(request.getParameterNames())
        .stream()
        .filter(key -> key.matches("targetBatchList\\[\\d+].userNo"))
        .count();

// 0번부터 순서대로 각 대상자의 세 필드 값을 직접 읽는다.
for (int i = 0; i < size; i++) {
    // 일반 사용자 번호: 문자열로 받은 값을 숫자로 바꾼다.
    long userNo = Long.parseLong(
        request.getParameter(
            "targetBatchList[" + i + "].userNo"
        )
    );

    // 위촉 사용자 번호도 같은 방식으로 읽는다.
    long candidateUserNo = Long.parseLong(
        request.getParameter(
            "targetBatchList[" + i + "].apntmUserNo"
        )
    );

    // 필수 신청 여부를 나타내는 Y/N 값을 읽는다.
    String essentialYn = request.getParameter(
        "targetBatchList[" + i + "].essentialYn"
    );

    // 위에서 읽은 값으로 신청 대상자를 생성한다. 실제 등록 코드는 생략했다.
}
대상자가 적을 때는 단순하고 이해하기 쉬운 구조였다. 하지만 대상자 수가 증가하면서 문제가 발생했다.
2. multipart의 part란 무엇인가?
multipart/form-data 요청은 하나의 HTTP 요청 본문을 여러 개의 part로 나누어 전송한다.
예를 들어 다음과 같은 FormData가 있다.
// FormData에 추가한 일반 필드와 파일은 각각 하나의 part가 된다.
const formData = new FormData();

formData.append("title", "교육 제목");
formData.append("startDate", "20260909");
// file은 사용자가 선택한 파일 객체다.
formData.append("attachment", file);
이 요청은 대략 다음과 같은 part로 구성된다.
part 1: title
part 2: startDate
part 3: attachment
파일 한 개도 하나의 part이고, 일반 폼 필드 하나도 하나의 part다.
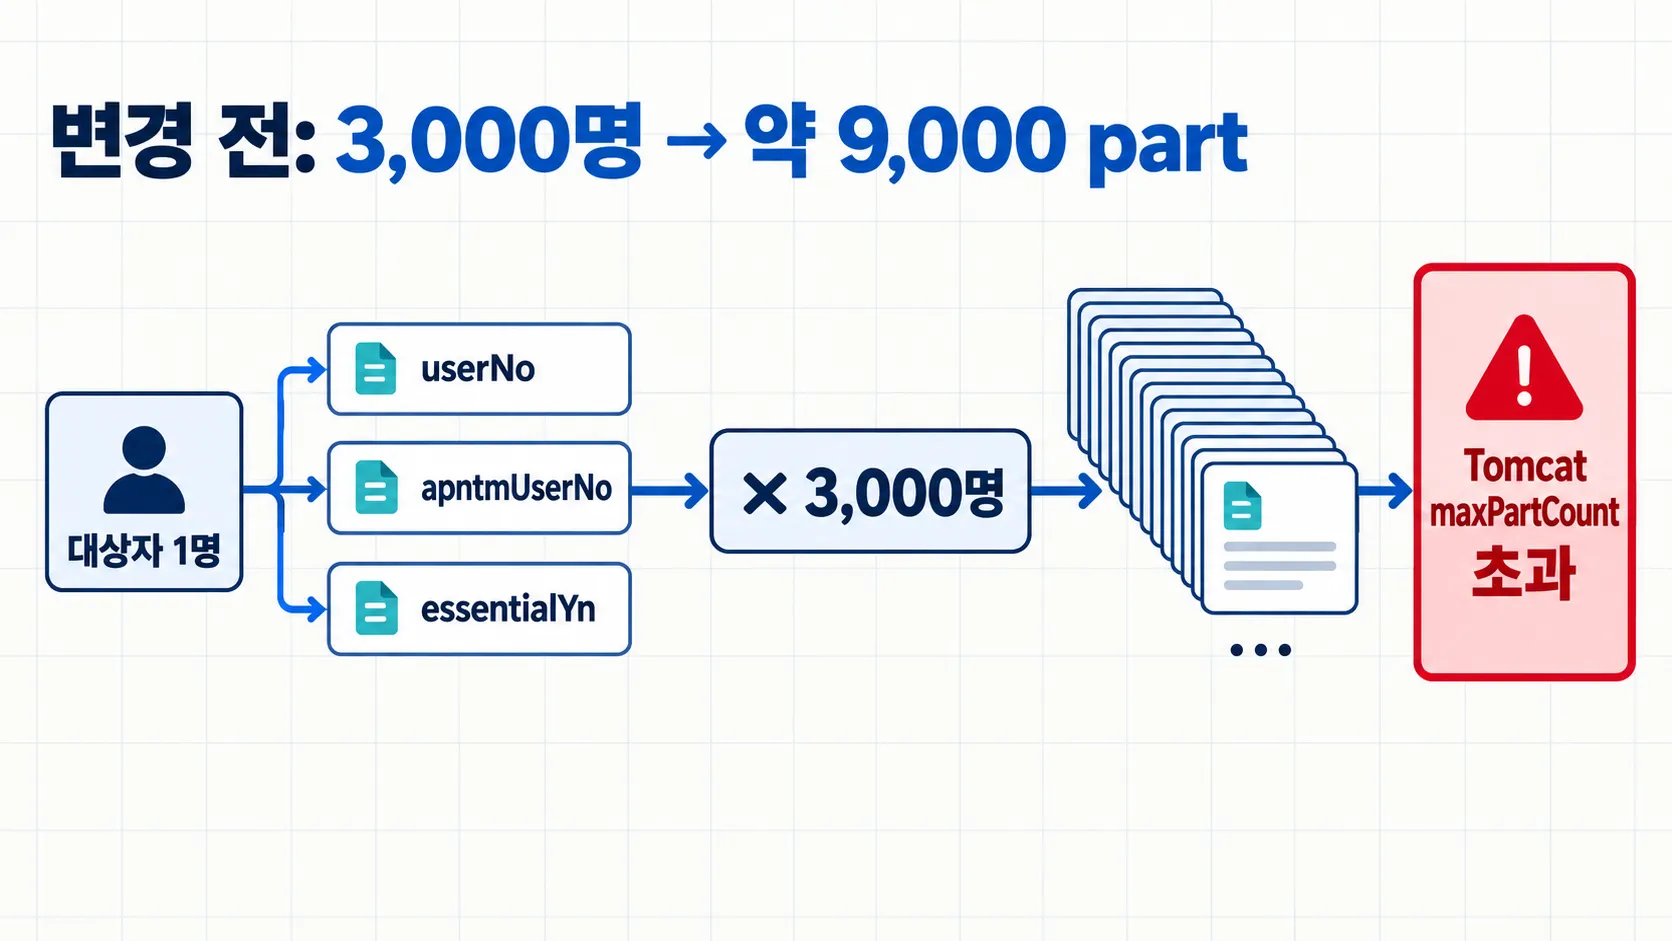
기존 프론트에서는 대상자 한 명에 대해 다음 세 값을 각각 FormData에 추가하고 있었다.
// 대상자마다 필드 세 개를 각각 추가하므로, 한 명당 part가 세 개 늘어난다.
targetBatchList.forEach((target, index) => {
    // 배열 위치(index)를 필드 이름에 넣어 대상자를 구분한다.
    formData.append(
        `targetBatchList[${index}].userNo`,
        target.userNo
    );

    // 위촉 사용자 번호도 별도의 part가 된다.
    formData.append(
        `targetBatchList[${index}].apntmUserNo`,
        target.apntmUserNo
    );

    // 필수 신청 여부 역시 별도의 part가 된다.
    formData.append(
        `targetBatchList[${index}].essentialYn`,
        target.essentialYn
    );
});
따라서 대상자 1명당 최소 3개의 part가 생성된다.
50명 × 3개 필드 = 150 part
3,000명 × 3개 필드 = 9,000 part
여기에 교육 기본정보와 첨부파일까지 더해지므로 실제 part 수는 더 많다.
대상자가 약 50명일 때부터 문제가 발생했던 이유도 여기에 있었다.
3. 요청은 왜 컨트롤러에 도착하기 전에 실패했을까?
Spring MVC에서는 파일이 포함된 multipart 요청이 들어오면, 컨트롤러가 처리하기 전에 요청 내용을 폼 필드와 파일로 나누는 작업이 먼저 이루어진다. 예를 들어 제목과 첨부 파일을 함께 전송하면, 서버는 요청 본문에서 제목은 문자열로, 첨부 파일은 파일 데이터로 구분해야 한다. 이 작업을 파싱이라고 한다. 이 환경에서는 Tomcat이 실제 파싱을 담당하고, Spring의 multipart resolver는 그 결과를 컨트롤러에서 사용할 수 있도록 연결해 준다.
요청이 들어와 컨트롤러에 도달하기까지의 흐름을 단순화하면 다음과 같다. 기본 설정에서는 컨트롤러가 실행되기 전에 multipart 파싱이 이루어진다.
클라이언트가 폼 필드와 파일을 함께 전송
    ↓
Tomcat이 요청을 받아 Spring MVC에 전달
    ↓
DispatcherServlet이 MultipartResolver 호출
    ↓
MultipartResolver가 Tomcat의 파싱 기능 이용
    ↓
Tomcat이 요청 본문을 폼 필드와 파일로 구분
    → 이 단계에서 maxPartCount 제한 확인
    ↓
파싱에 성공하면 Controller 실행
    ↓
Service 실행maxPartCount는 multipart 요청에 포함할 수 있는 part의 최대 개수다. 여기서 part는 요청 본문을 구성하는 개별 항목으로, 폼 필드와 파일이 각각 해당한다. Tomcat은 요청 본문을 파싱하면서 이 개수가 제한을 넘는지 확인한다.
따라서 이 단계에서 part 수 초과로 파싱이 실패하면, 요청은 컨트롤러까지 도달하지 못한다. 컨트롤러와 서비스에 작성한 다음 코드도 실행되지 않는다.
// 메서드 인자와 업무 로직을 생략한 설명용 코드다.
@PostMapping("/education")
public void createEducation(...) {
    // multipart 파싱에 실패하면 여기까지 도달하지 못한다.
}
서버 내부에서 데이터를 분할해 처리하려 해도, 요청 자체가 파싱되지 않았기 때문에 서비스 로직에서 해결할 수 없는 문제였다.
4. maxPartCount는 왜 존재할까?
처음에는 maxPartCount를 충분히 크게 올리면 해결할 수 있다고 생각했다.
예를 들어 3,000명에게 3개의 필드가 필요하다면 다음과 같이 계산할 수 있다.
3,000명 × 3개 필드 = 9,000 part
기타 폼 필드 및 첨부파일 포함 → 약 10,000~12,000 part
Tomcat 설정을 다음처럼 올리는 방법도 가능했다.
// 검토만 한 설정 상향 방식이다. 최종 해결에는 이 설정을 사용하지 않았다.
@Configuration
public class TomcatConfig {

    // 내장 Tomcat이 시작될 때 커넥터 설정을 변경하는 빈을 등록한다.
    @Bean
    public WebServerFactoryCustomizer<TomcatServletWebServerFactory>
    tomcatCustomizer() {
        return factory ->
            factory.addConnectorCustomizers(
                // 요청 한 건에 허용할 part 개수를 12,000개로 높인다.
                connector -> connector.setMaxPartCount(12000)
            );
    }
}
하지만 maxPartCount는 단순한 불편한 제한이 아니다.
multipart part가 많아질수록 서버는 각 part를 파싱하고 메타데이터와 임시 객체를 생성해야 한다. 이 과정에서 다음 리소스가 사용된다.
- CPU
- 메모리
- 임시 객체
- 요청 처리 스레드
- 파일 part의 경우 임시 저장 공간
비정상적으로 많은 part를 포함한 요청은 서버 자원을 과도하게 점유할 수 있고, 서비스 거부 공격에도 활용될 수 있다.
즉 maxPartCount는 서버를 보호하기 위한 안전장치다.
업무 데이터가 증가할 때마다 이 제한을 계속 높이는 것은 다음과 같은 문제가 있다.
- multipart 파싱 비용은 그대로 증가한다.
- 하나의 API 요구 때문에 서버 전체의 허용 범위를 넓히게 된다.
- 예상보다 더 큰 요청이 들어오는 것을 막기 어렵다.
- 데이터가 3,000명에서 5,000명으로 늘면 다시 설정을 변경해야 한다.
따라서 설정값을 높이는 대신 요청 구조에서 part 수 자체를 줄이는 방향을 선택했다.
5. 검토한 해결 방법
방법 1. maxPartCount 상향
가장 간단한 방법이다.
// 요청 한 건의 part 허용 개수만 높인다. 전송되는 part 수 자체는 줄어들지 않는다.
connector.setMaxPartCount(12000);
장점:
- 백엔드와 프론트 변경이 거의 없다.
- 빠르게 적용할 수 있다.
단점:
- 대량 part 파싱 비용은 그대로 발생한다.
- 서버 보호 범위를 과도하게 완화한다.
- 대상자 수가 다시 증가하면 같은 문제가 반복된다.
단기 대응에는 사용할 수 있지만 근본적인 해결책으로는 적합하지 않다고 판단했다.
방법 2. 교육 등록과 대상자 등록 API 분리
교육을 먼저 등록하고, 생성된 교육 ID를 사용해 대상자 목록을 별도의 JSON API로 등록하는 방법이다.
POST /education
POST /education/{id}/targets
구조적으로는 명확하지만 다음 사항을 추가로 고려해야 한다.
- 교육 등록과 대상자 등록을 어디까지 하나의 성공·실패 단위로 볼지 결정
- 첫 번째 요청 성공 후 두 번째 요청 실패
- 재시도 및 중복 처리
- 프론트 흐름 변경
- 기존 API와의 호환성
장기적으로 검토할 수 있지만 이번 문제를 해결하기에는 변경 범위가 컸다.
방법 3. multipart는 유지하고 대상자 목록만 JSON으로 전송
교육 기본정보와 첨부파일은 기존 multipart 구조를 유지한다.
다만 대상자별 필드를 개별 part로 보내지 않고, 대상자 배열 전체를 JSON 문자열 하나로 만들어 전송한다. 객체나 배열을 전송할 수 있는 문자열 형태로 바꾸는 작업을 직렬화라고 한다.
교육 기본정보: 기존 multipart 필드 유지
첨부파일: 기존 파일 part 유지
대상자 목록: JSON 문자열 1 part
기존 업무 로직에 미치는 영향이 가장 적으면서 part 수를 근본적으로 줄일 수 있어 이 방법을 선택했다.
6. 프론트엔드 전송 구조 변경
변경 전
// 파일과 입력값을 담아 서버로 보낼 multipart 요청 본문을 만든다.
const formData = new FormData();

// 대상자마다 필드 세 개를 각각 추가하므로, 한 명당 part가 세 개 늘어난다.
targetBatchList.forEach((target, index) => {
    // 배열 위치(index)를 필드 이름에 넣어 대상자를 구분한다.
    formData.append(
        `targetBatchList[${index}].userNo`,
        target.userNo
    );

    // 위촉 사용자 번호도 별도의 part가 된다.
    formData.append(
        `targetBatchList[${index}].apntmUserNo`,
        target.apntmUserNo
    );

    // 필수 신청 여부 역시 별도의 part가 된다.
    formData.append(
        `targetBatchList[${index}].essentialYn`,
        target.essentialYn
    );
});
대상자 3,000명이라면 약 9,000개의 part가 생성된다.
변경 후
백엔드 신청 처리에 실제로 필요한 필드만 추출했다.
// 대상자마다 서버에서 사용할 세 필드만 남긴 새 배열을 만든다.
const targetPayload = targetBatchList.map(target => ({
    // 번호가 null 또는 undefined이면 0을 넣는다.
    userNo: target.userNo ?? 0,
    apntmUserNo: target.apntmUserNo ?? 0,
    essentialYn: target.essentialYn
}));

// 배열 전체를 JSON 문자열로 바꾸어 하나의 일반 폼 필드에 담는다.
formData.append(
    "targetBatchListJson",
    JSON.stringify(targetPayload)
);
이제 대상자 수와 관계없이 대상자 목록은 하나의 문자열 part로 전송된다.
3,000명 → targetBatchListJson 1 part첨부파일은 기존처럼 추가한다.
// 대상자 목록만 JSON으로 바꾸고, 파일은 기존처럼 파일마다 part로 추가한다.
files.forEach(file => {
    formData.append("attachment", file);
});
대상자 목록은 JSON.stringify()로 문자열로 변환해 FormData에 넣어야 한다. 백엔드에서 request.getParameter("targetBatchListJson")으로 이 문자열을 읽기 때문이다.
7. 백엔드 JSON 파싱 구조
대상자 JSON 배열의 요소 한 개를 자바 객체 한 개로 옮겨 담을 전용 DTO를 추가했다.
// Lombok이 각 필드의 값을 읽고 쓰는 getter/setter 메서드를 생성한다.
@Getter
@Setter
public class TargetBatchDto {

    // JSON 배열 속 대상자 한 명의 정보를 담는다.
    private long userNo;        // 일반 사용자 번호
    private long apntmUserNo;   // 위촉 사용자 번호
    private String essentialYn; // 필수 신청 여부(Y/N)
}
대상자 JSON 문자열을 자바 객체 목록으로 변환하기 위해 Jackson 라이브러리의 ObjectMapper를 사용했다.
multipart 요청에서 JSON 문자열을 읽어 DTO 목록으로 변환한다. 이렇게 전송된 문자열을 자바 객체로 되돌리는 작업을 역직렬화라고 한다. 아래 예제는 이 변환 과정만 보여 준다.
private List<TargetBatchDto> parseTargetBatchList(
        MultipartHttpServletRequest request
) {
    // 프론트에서 같은 이름으로 추가한 일반 폼 필드 값을 읽는다.
    String targetBatchListJson =
        request.getParameter("targetBatchListJson");

    if (targetBatchListJson == null
            || targetBatchListJson.isBlank()) {
        return Collections.emptyList();
    }

    try {
        // JSON 배열의 각 요소를 TargetBatchDto 객체로 변환한다.
        return objectMapper.readValue(
            targetBatchListJson,
            // 배열 요소의 타입까지 ObjectMapper에 알려 준다.
            new TypeReference<List<TargetBatchDto>>() {}
        );
    } catch (JsonProcessingException e) {
        // JSON 형식이 잘못된 경우 업무에서 사용할 오류 메시지로 바꾼다.
        throw new BusinessException(
            "교육 대상자 목록 형식이 올바르지 않습니다."
        );
    }
}
변환한 DTO 목록은 기존 로직에 전달해 일반 사용자와 위촉 사용자로 분리하고 일괄 신청을 처리한다.
전송 형식만 변경했고, 이후의 신청 가능 여부 검증과 DB 저장 로직은 기존 코드를 재사용했다.
8. 변경 전후 비교
변경 전
교육 기본정보 N개 part
+ 대상자 3,000명 × 3개 part
+ 첨부파일 part
대상자 데이터에만 약 9,000개의 part가 필요했다.
변경 후
교육 기본정보 N개 part
+ 대상자 JSON 1개 part
+ 첨부파일 part
대상자 데이터의 multipart part 수가 대상자 수에 비례하지 않게 됐다.
| 구분 | 변경 전 | 변경 후 |
|---|---|---|
| 대상자 수 | 3,000명 | 3,000명 |
| 대상자 관련 multipart part | 약 9,000개 | 1개 |
| 대상자 데이터 파싱 | 다수 파라미터 개별 조회 | JSON 문자열 하나를 한 번에 DTO 목록으로 변환 |
| Tomcat part 제한 | 초과 | 정상 범위 |
| 기존 첨부파일 처리 | 유지 | 유지 |
9. 일부 사용자만 등록되는 추가 문제
multipart 문제를 해결한 뒤 대량 등록을 테스트하던 중, 요청한 사용자 중 일부만 등록되는 현상도 발견했다.
일괄 신청 로직은 사용자별로 신청을 시도하고, 비즈니스 검증에 실패하면 예외를 잡고 다음 사용자를 계속 처리하고 있었다.
// 전체 반복문 중 사용자 한 명을 처리하는 부분이다.
try {
    // 신청 조건을 검증하고 등록한다. 성공하면 결과에 SUCCESS를 기록한다.
    applyEducation(application);
    result.put(userNo, "SUCCESS");
} catch (BusinessException e) {
    // 업무 조건을 충족하지 못하면 사유를 기록하고, 바깥 반복문은 다음 사용자를 처리한다.
    result.put(userNo, e.getMessage());
}
일부 대상자의 신청이 실패해도 나머지 대상자는 계속 처리하도록 되어 있었다. 하지만 사용자별 처리 결과를 반환받고도 로그로 남기지 않아, 누가 어떤 이유로 실패했는지 파악하기 어려웠다.
// 개선 전 호출부: 사용자별 성공/실패 결과를 반환받아도 확인하거나 기록하지 않았다.
applyEducationBatch(batchDto);
사용자별로 다음과 같은 이유로 신청이 실패할 수 있었다.
- 신청 대상 조건 미충족
- 이미 해당 교육에 신청함
- 신청 정원 초과
- 동일 교육과정 기수료
- 필수 선행과정 미수료
- 신청 기간이 아님
따라서 개별 실패와 전체 결과를 로그로 남기도록 개선했다.
// 실패한 교육·사용자·사유를 함께 남겨 어떤 건을 확인해야 하는지 추적한다.
log.warn(
    "교육 일괄 신청 실패 - educationId: {}, "
        + "userType: USER, userNo: {}, reason: {}",
    educationId,
    userNo,
    exception.getMessage() // 사용자별 신청 실패 사유
);
처리 완료 후에는 성공·실패 건수와 실패 사유별 집계를 남겼다.
// 일괄 처리가 끝난 뒤 전체 결과를 한 번에 확인할 수 있도록 요약한다.
log.info(
    "교육 일괄 신청 처리 결과 - "
        + "educationId: {}, total: {}, "
        + "success: {}, failure: {}, "
        + "failureReasons: {}",
    educationId,
    totalCount,          // 처리를 시도한 전체 건수
    successCount,        // 등록 성공 건수
    failureCount,        // 등록 실패 건수
    failureReasonCounts  // 사유별 실패 건수(예: 이미 수료한 과정 159건)
);
로그 예시는 다음과 같다.
교육 일괄 신청 처리 결과 -
educationId: 123,
total: 200,
success: 41,
failure: 159,
failureReasons: {
    이미 수료한 과정은 신청할 수 없습니다.=159
}
이를 통해 다음 두 문제를 명확하게 구분할 수 있게 됐다.
요청 자체가 실패함
→ multipart 파싱 또는 요청 형식 문제

일부 사용자만 등록됨
→ 사용자별 비즈니스 검증 실패
10. 테스트
다음 시나리오를 검증했다.
정상 JSON
[
  {
    "userNo": 101,
    "apntmUserNo": 0,
    "essentialYn": "Y"
  },
  {
    "userNo": 0,
    "apntmUserNo": 202,
    "essentialYn": "N"
  }
]
첫 번째 요소는 일반 사용자 번호(userNo)가 있는 필수 신청 대상이고, 두 번째 요소는 위촉 사용자 번호(apntmUserNo)가 있는 선택 신청 대상이다. 각 번호가 0이면 해당 유형의 번호가 없다는 뜻이다. 두 대상자가 각각 올바른 목록으로 분류되는지 확인했다.
빈 배열
[]대상자가 없는 경우 빈 신청 목록으로 정상 처리되는지 확인했다.
잘못된 JSON
not-json잘못된 대상자 목록이 명확한 비즈니스 예외로 변환되는지 확인했다.
3,000건 대상자
3,000개의 대상자 객체를 하나의 JSON 문자열로 생성하고 다음 항목을 확인했다.
- multipart 파라미터는
targetBatchListJson한 개 - JSON 배열은 3,000개 DTO로 변환
- 마지막 대상자의 사용자 번호까지 정상 매핑
- 컴파일 및 단위 테스트 성공
11. 결과
기존에는 multipart part 제한 때문에 약 50명의 대상자만 한 번에 등록할 수 있었다.
요청 구조 개선 후에는 다음 결과를 얻었다.
대상자 관련 multipart part
약 9,000개 → 1개

검증 가능한 일괄 등록 범위
약 50명 → 3,000명
Tomcat의 maxPartCount 값을 업무 데이터 크기에 맞춰 과도하게 상향하지 않고도 문제를 해결했다.
또한 기존의 다음 구조는 그대로 유지했다.
- 교육 기본정보의
@ModelAttribute바인딩 - 첨부파일 업로드
- 교육 대상 조건 저장
- 일반 사용자와 위촉 사용자 분류
- 신청 가능 여부 검증
- 기존 DB 저장 로직
변경 범위를 대량 대상자 목록의 전송 및 파싱 부분으로 제한해 기존 기능에 미치는 영향을 줄였다.
12. 이번 개선의 범위와 한계
이번 개선은 대용량 트래픽 처리보다는 대량 데이터가 포함된 단일 multipart 요청 구조 최적화에 가깝다.
개선한 영역은 다음과 같다.
- multipart part 수
- Tomcat 요청 파싱 안정성
- 서버의 multipart 메타데이터 처리 부담
- 대상자 목록 변환 방식
- 전체 중 일부만 성공했을 때 성공·실패 건수와 원인을 확인하는 방법
반면 사용자별 DB 조회와 저장은 여전히 반복적으로 수행된다.
대상자가 더 많아지거나 동시에 많은 요청이 들어온다면 다음 개선도 검토할 수 있다.
- 사용자 신청 가능 여부 일괄 조회
- 여러 건의 DB 저장·수정 요청을 묶어서 처리하는 배치 방식
- 전체 데이터를 적절한 크기의 묶음(chunk)으로 나누어 처리
- HTTP 요청에서는 작업을 접수하고, 실제 처리는 별도 작업 큐에서 수행
- 사용자가 접수한 작업의 진행·완료·실패 상태를 조회하는 API
- 요청별 고유 식별값(idempotency key)을 저장해 같은 요청이 다시 와도 중복 반영하지 않도록 처리
- 부분 실패 결과를 클라이언트에 직접 반환
즉 이번 작업은 업무 처리 코드에 도착하기도 전에 요청을 해석하는 단계에서 막히던 문제를 해결한 것이며, 전체 대량 처리 아키텍처의 최종 단계는 아니다.
마무리
처음에는 maxPartCount를 높이면 간단히 해결되는 문제처럼 보였다.
하지만 해당 설정이 존재하는 이유를 확인해 보니, 제한을 완화하는 것보다 요청 구조 자체를 개선하는 편이 더 안전하고 확장 가능한 해결책이었다.
이번 문제를 통해 다시 확인한 점은 다음과 같다.
- 예외 이름만 보고 파일 크기 문제라고 단정하지 않는다.
- 요청이 어느 계층에서 실패했는지 먼저 확인한다.
- 서버 보호 설정을 변경하기 전에 설정의 목적을 이해한다.
- 설정 상향과 구조 개선의 장단점을 비교한다.
- 대량 처리에서는 성공 여부뿐 아니라 부분 실패를 관찰할 수 있어야 한다.
- 문제 영역만 변경하고 기존 업무 로직은 최대한 재사용한다.
단순히 제한값을 높이는 대신 데이터가 전달되는 방식을 바꾸는 것만으로도, 서버 보호 설정을 유지하면서 처리 범위를 크게 확장할 수 있었다.
요약
문제:
대상자별 필드가 개별 multipart part로 전송되어
Tomcat maxPartCount 제한 초과

기존:
3,000명 × 3개 필드 ≈ 9,000 part

개선:
대상자 배열을 JSON 문자열 하나로 직렬화
→ targetBatchListJson 1 part

결과:
약 50명 → 3,000명 기준 처리 검증
Tomcat 보호 설정 유지
기존 첨부파일 및 업무 로직 재사용
부분 실패 진단 로그 추가